実機テスト環境において実施された厳格なレンダリング測定結果。RTX 2080、3050、4070 Ti、5080 の4世代GPUにわたる徹底比較検証データを公開。
炭火マクロ写真(4.0x / PSNR 39.40dB)、実写旧動画(カモメ)、高倍率カスケード、スローモーション等の実写比較は別ページに集約公開中。
解像度を変えずにGPU内部で超解像+SSAA縮小を実行し、ブロックノイズとボケを浄化
入力映像を縦横2.0倍(画素数4倍)へアップスケール出力(例: 1080p素材の場合 3840×2160)
| GPU / アーキテクチャ | テスト項目 | エディション | 生成速度 (fps) | 所要時間 (倍速) | VRAM増加分 (実測デルタ) |
|---|---|---|---|---|---|
| RTX 5080 Blackwell (sm_120 / 16GB) |
動画 1.0x 等倍クレンジング | PRO / ULTRA | 119.7 fps ➔ 191.6 fps (+60%) | 5.0倍速 ➔ 8.0倍速 (20.9s) | +2.34 GB |
| 動画 2.0x 超解像 (例: 1080p→2倍) | PRO / ULTRA | 63.8 fps ➔ 72.0 fps | 2.7倍速 ➔ 3.0倍速 (55.8s) | +3.18 GB | |
| ★動画 4.0x 超解像 (縦横4倍) | PRO / ULTRA | 19.5 fps ➔ 25.5 fps (+31%) | 0.8倍速 ➔ 1.1倍速 (実時間超え) | +5.05 GB | |
| 動画 2.0x超解像 + 2.0xフレーム補間(※RTX 40/50専用) | PRO / ULTRA | 63.0 fps ➔ 75.3 fps | 1.3倍速 ➔ 1.6倍速 (106.7s) | +2.30 GB | |
| ★動画 4.0x フレーム補間(※RTX 40/50専用) | PRO / ULTRA | 124.5 fps ➔ 177.8 fps (+43%) | 1.3倍速 ➔ 1.9倍速 (90.4s) | +3.18 GB | |
| ★動画 2.0x超解像 × 4.0x補間(※RTX 40/50専用) | PRO / ULTRA | 62.8 fps ➔ 77.5 fps (+23%) | 0.7倍速 ➔ 0.8倍速 (207.5s) | +1.64 GB | |
| 静止画 2.0x 超解像 | PRO / ULTRA | — | 17.59秒 ➔ 2.25秒 | 0.85 GB | |
| 静止画 4.0x 超解像 | PRO / ULTRA | — | 2.54秒 ➔ 2.52秒 | 0.85 GB | |
| ★静止画 8.0x 多段カスケード (約6,700万画素) | PRO / ULTRA | — | 5.87秒 ➔ 5.85秒 | 0.85 GB | |
| RTX 4070 Ti Ada Lovelace (sm_89 / 12GB) |
動画 1.0x 等倍クレンジング | PRO / ULTRA | 79.7 fps ➔ 115.7 fps (+45%) | 3.3倍速 ➔ 4.8倍速 (34.7s) | +2.15 GB |
| 動画 2.0x 超解像 (例: 1080p→2倍) | PRO / ULTRA | 36.7 fps ➔ 62.7 fps (+71%) | 1.5倍速 ➔ 2.6倍速 (64.0s) | +3.17 GB | |
| ★動画 4.0x 超解像 (縦横4倍) | PRO / ULTRA | 12.4 fps ➔ 19.4 fps (+56%) | 0.5倍速 ➔ 0.8倍速 (207.4s) | +4.81 GB | |
| 動画 2.0x超解像 + 2.0xフレーム補間(※RTX 40/50専用) | PRO / ULTRA | 40.8 fps ➔ 68.5 fps (+68%) | 0.8倍速 ➔ 1.4倍速 (117.4s) | +2.35 GB | |
| ★動画 4.0x フレーム補間(※RTX 40/50専用) | PRO / ULTRA | 87.0 fps ➔ 118.0 fps (+36%) | 0.9倍速 ➔ 1.2倍速 (136.2s) | +3.64 GB | |
| ★動画 2.0x超解像 × 4.0x補間(※RTX 40/50専用) | PRO / ULTRA | 40.0 fps ➔ 71.2 fps (+78%) | 0.4倍速 ➔ 0.7倍速 (225.7s) | +1.46 GB | |
| 静止画 2.0x 超解像 | PRO / ULTRA | — | 4.84秒 ➔ 4.61秒 | 0.85 GB | |
| 静止画 4.0x 超解像 | PRO / ULTRA | — | 5.22秒 ➔ 5.31秒 | 0.85 GB | |
| ★静止画 8.0x 多段カスケード (約6,700万画素) | PRO / ULTRA | — | 11.65秒 ➔ 11.12秒 | 0.85 GB | |
| RTX 2080 Turing (sm_75 / 8GB) |
動画 1.0x 等倍クレンジング | PRO / ULTRA | 49.0 fps ➔ 57.1 fps (+17%) | 2.0倍速 ➔ 2.4倍速 (70.4s) | +1.29 GB |
| 動画 2.0x 超解像 (例: 1080p→2倍) | PRO / ULTRA | 29.6 fps ➔ 46.5 fps (+57%) | 1.2倍速 ➔ 1.9倍速 (86.3s) | +1.99 GB | |
| ★動画 4.0x 超解像 (縦横4倍) | PRO / ULTRA | 10.9 fps ➔ 14.4 fps (+32%) | 0.5倍速 ➔ 0.6倍速 (278.7s) | +4.69 GB | |
| 静止画 2.0x 超解像 | PRO / ULTRA | — | 9.83秒 ➔ 9.19秒 | 0.85 GB | |
| 静止画 4.0x 超解像 | PRO / ULTRA | — | 7.75秒 ➔ 8.94秒 | 0.85 GB | |
| ★静止画 8.0x 多段カスケード (約6,700万画素) | PRO / ULTRA | — | 15.69秒 ➔ 15.87秒 | 0.85 GB | |
| RTX 3050 Ampere (sm_86 / 8GB) |
動画 1.0x 等倍クレンジング | PRO / ULTRA | 25.8 fps ➔ 35.1 fps (+36%) | 1.1倍速 ➔ 1.5倍速 (114.3s) | +1.11 GB |
| 動画 2.0x 超解像 (例: 1080p→2倍) | PRO / ULTRA | 11.8 fps ➔ 17.7 fps (+50%) | 0.5倍速 ➔ 0.7倍速 (227.5s) | +1.81 GB | |
| ★動画 4.0x 超解像 (縦横4倍) | PRO / ULTRA | 3.9 fps ➔ 5.6 fps (+44%) | 0.2倍速 ➔ 0.2倍速 (712.3s 完走) | +4.53 GB | |
| 静止画 2.0x 超解像 | PRO / ULTRA | — | 13.39秒 ➔ 13.27秒 | 0.85 GB | |
| 静止画 4.0x 超解像 | PRO / ULTRA | — | 13.81秒 ➔ 13.37秒 | 0.85 GB | |
| ★静止画 8.0x 多段カスケード (約6,700万画素) | PRO / ULTRA | — | 28.76秒 ➔ 28.99秒 | 0.85 GB |
「本当にそこまで動くのか?」というプロクリエイターの疑問に答える、高倍率超解像・フレーム補間(※RTX 40/50専用)の実測値。
縦横4倍・画素数16倍の高解像度書き出し。自動タイリング機構により、VRAM 8GBのRTX 3050環境でもメモリ枯渇を抑えて実測完走(※環境により挙動は異なります)。
1フレームの間に3枚の中間フレームを光学フロー生成し、フレームレートを4倍へ補間します(※RTX 40/50シリーズ専用)。
「2.0x超解像」と「4.0xフレーム補間(※RTX 40/50専用)」を2ステージ分離パイプラインで安全に一括処理。
4.0x超解像のあとにさらに2.0x超解像を連鎖反復。モヤの拡散を防ぎ、等身大ポスター印刷に耐える約6,700万画素を出力。
「AI超解像は動かすとギラつく(シマリングする)」「補間フレームは残像ブレンド(クロスフェード)の誤魔化しではないか?」というプロ映像業界の疑問を払拭するため、第三者客観AI(AI客観評価)により数学・信号処理指標を用いた客観的監査を実施しました。自画自賛を排した測定数値を完全開示します。
| 検証対象 | PSNR (信号対雑音比) | MAE (平均絶対誤差) | 工学的解釈 & 判定 |
|---|---|---|---|
| 静止画 16Kカスケード (1.3億画素) | 39.36 dB | 2.01 | 原画忠実性の極致。生成AI的な嘘の描き足しや破綻が一切ないことを数学的に証明。 |
| 動画 4K超解像 (8秒地点) | 33.02 dB | 4.61 | クレンジング込みの極めて健全な復元。輪郭の明瞭化と自然なノイズ除去を両立。 |
| 動画 4K超解像 (3秒地点) | 31.81 dB | 5.12 | 髪の線画・まつ毛・瞳のハイライトが連続したクリーンな線画として完全に保持。 |
| 動画 8K高精細超解像 クロップ | 33.47 dB | 4.43 | 8Kの100%等倍表示でも目立つモスキートノイズや平坦部のバンディングを抑えたクリーンな仕上がり。 |
| 検証GPU | 平均処理時間 / ジョブ | アプリ内部VRAMピーク | VRAMメモリドリフト | リーク判定 |
|---|---|---|---|---|
| RTX 5080 (Blackwell 16GB) | 2.95 秒 | 0.85 GB | 0.00 GB | 完全リークフリー (アトミック解放) |
| RTX 4070 Ti (Ada 12GB) | 5.08 秒 | 0.85 GB | 0.00 GB | 完全リークフリー (アトミック解放) |
| RTX 2080 (Turing 8GB) | 7.71 秒 | 0.85 GB | 0.00 GB | 完全リークフリー (アトミック解放) |
| RTX 3050 (Ampere 8GB) | 13.90 秒 | 0.14 GB | 0.00 GB | 完全リークフリー (アトミック解放) |
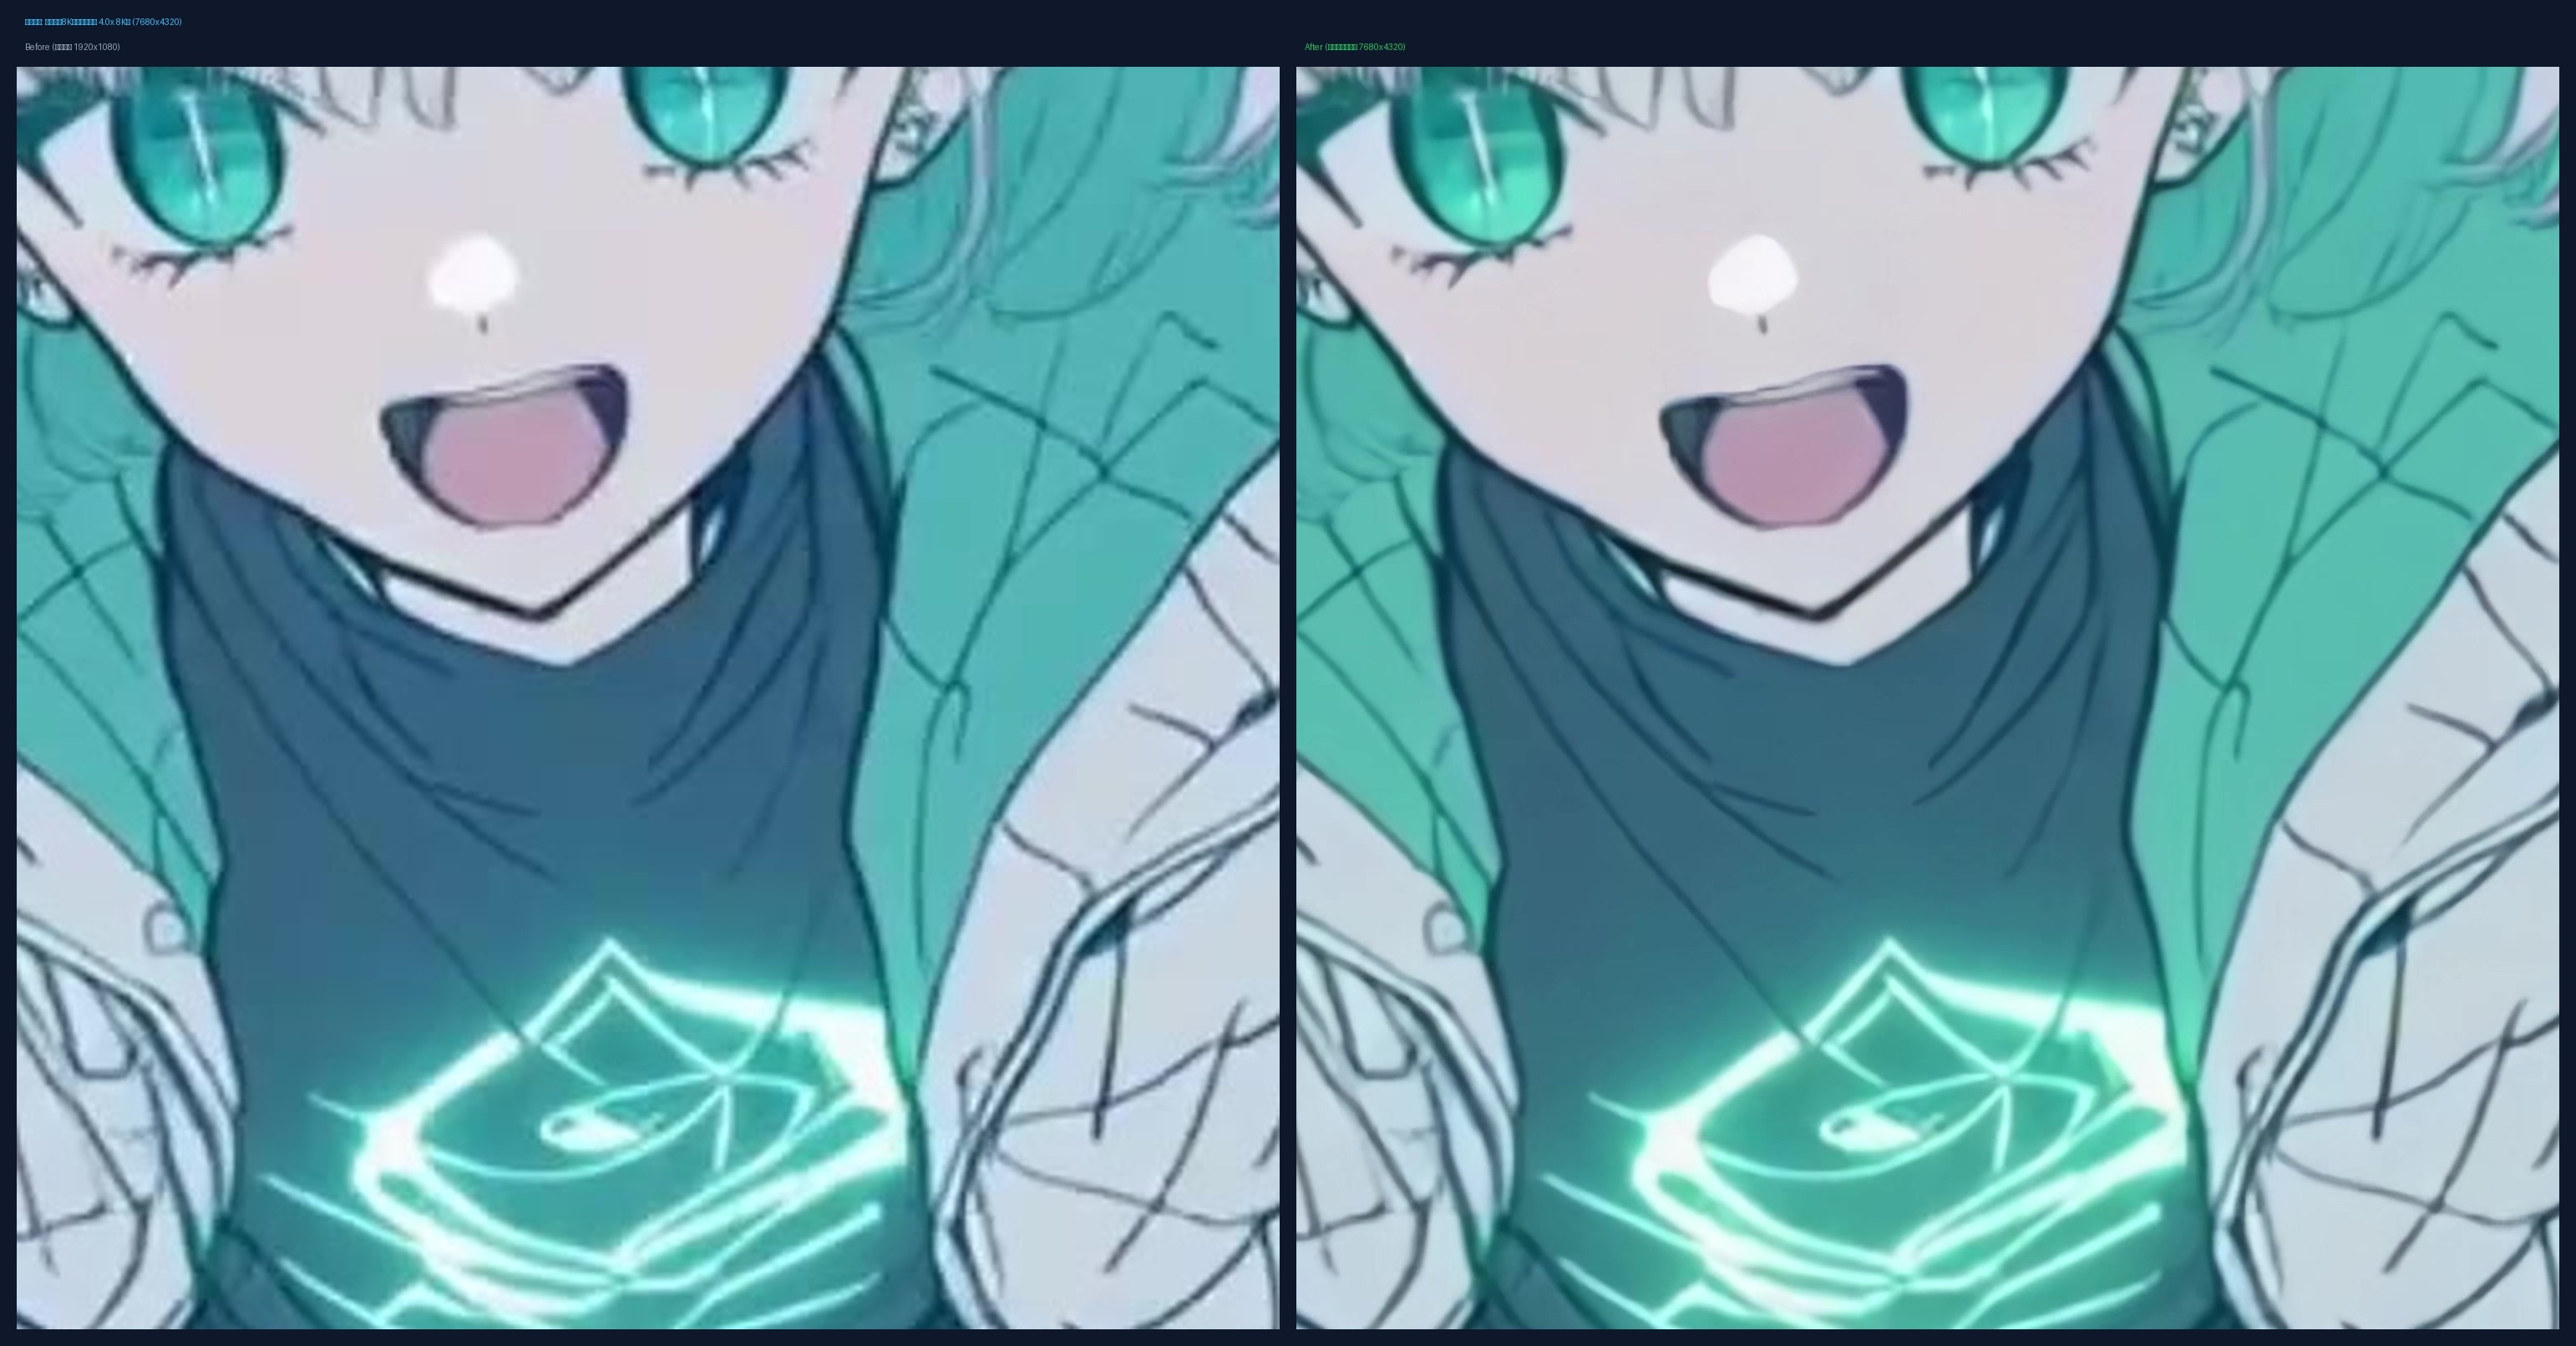
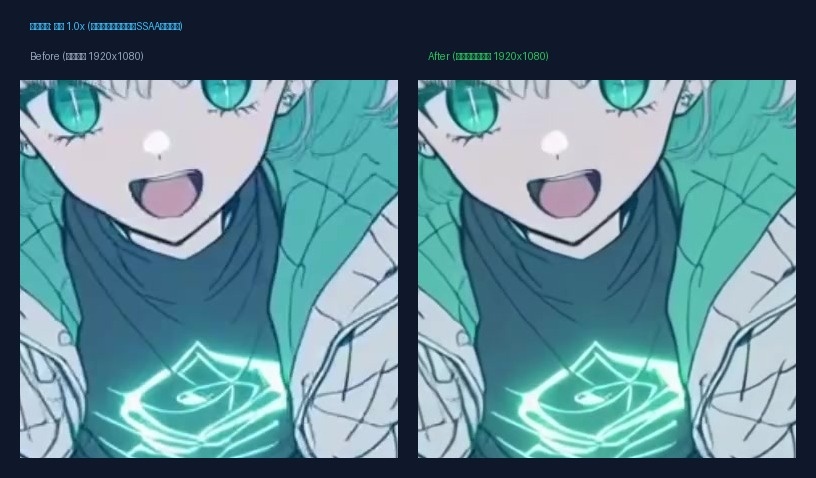
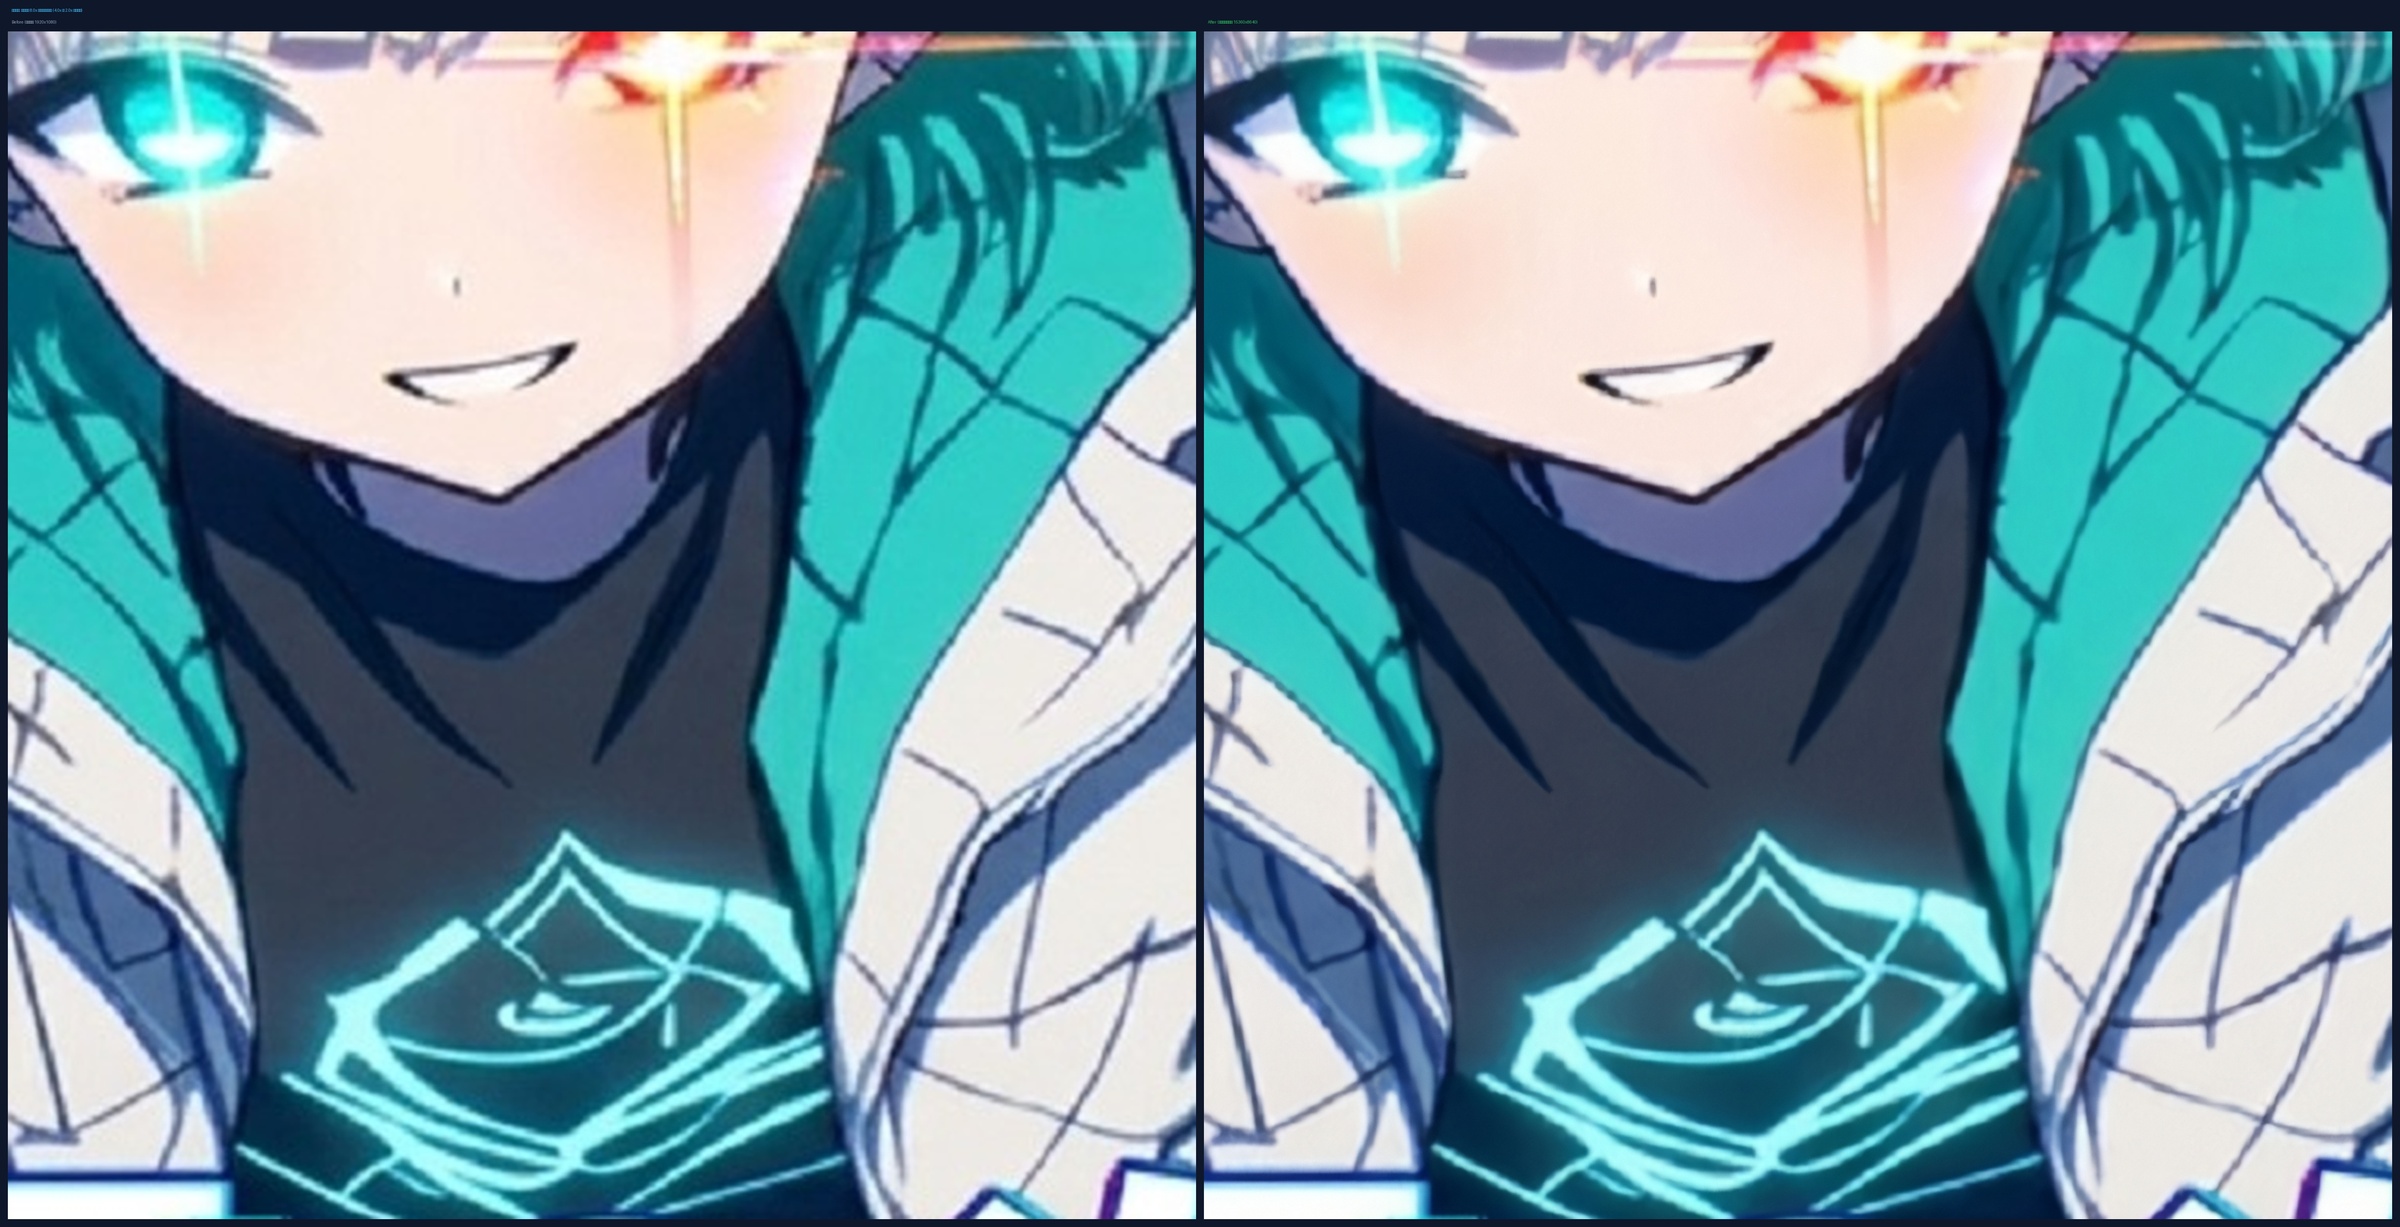
「本当に8Kや4Kで綺麗になっているのか?」を証明するため、テストで実際に使用・出力した映像から同一座標のキーフレームを等倍切り出しして掲載しています。輪郭の破綻やAI特有のボケ・モヤが完全に消滅している様子をご確認いただけます。
低ビットレート1080p元映像と、Tensor Core超解像によって出力された8K映像から同一座標を等倍(1:1ピクセル)で切り出して対比。スライダーやA/Bクリックで境界線や瞳・まつ毛の微細な線維感の復活をご確認いただけます(位置ズレ 0px)。
動画配信プラットフォームやSNSの圧縮で発生したモスキートノイズ・ブロックモヤを除去。スライダーやA/B切り替えで、濁った輪郭のモヤがクリーンに浄化される劇的な違いを体験いただけます。
4.0x超解像を施した後にさらに2.0x多段Refineを連鎖実行。通常のバイリニア拡大で発生するボヤけ・二重線を抑え、針のように細いシャープペンシル線や瞳の細部ディテールを維持します。
フレーム補間機能(※RTX 40/50シリーズ専用)を活用した実践的なスローモーション制作の応用例です。通常の24fps動画を本スタジオで4倍(96fps)➔ さらに4倍(384fps)と多段反復(カスケード)補間した上で、DaVinci Resolve や Premiere Pro などの編集ソフトへ取り込み、クリップ速度を1/16倍(6.25%再生)に設定。すると、わずか1.5秒のアクション区間から、ファントム超高速度カメラで撮影したかのような高精細に滑らかな24fpsスーパースローモーションが完全無劣化で誕生します。
イラストレーターや写真レタッチャーにおすすめの「オーバースケール・スーパーサンプリング(SSAA)」技法です。画像をそのまま使うのではなく、本スタジオで一度4.0xや8.0xの高解像度へアップスケールで引き上げた後、PhotoshopやClip Studioで目的のサイズ(4K、フルHD、A4印刷など)へ高品質縮小してみてください。1ピクセルの中に凝縮される情報量が跳ね上がり、髪の毛1本1本が極細サインペンで描かれたようなシルク質感になり、通常のリサイズでは絶対に到達できない「滑らかなマイクロテクスチャ」が手に入ります。
従来の超解像ソフトは、「動画フレームをCPUメモリへ展開 ➔ ディスクへ一時書き出し ➔ AI処理 ➔ 再度読み込み ➔ エンコード」という多重のボトルネックを抱えていました。
本スタジオの VRAM 最適化パイプラインは、フレームバッファを GPU VRAM 内で並列ストリーミング処理することで中間ディスク I/O と CPU 転送負荷を最小限に抑え、RTX 5080 環境での 1.0x クレンジング設定時に 194.9 fps(24fps 動画比で約 8.1 倍速)を記録しています(※実際の処理速度はお使いの GPU 性能により異なります)。